アニメやゲームで気になったキャラクターの声優さんが、ASMR作品にも出演していないか調べたことはありませんか?
「キャラクターの名前は分かるけれど、担当声優を覚えていない」「声優名は分かったけれど、どのASMR作品に出演しているのかを一件ずつ探すのが面倒」。そんなとき、キャラクター・声優・ASMR作品を一続きで検索できれば便利だと考えました。
そこで開発したのが、声優名・アニメやゲームの作品名・キャラクター名からASMR作品を横断検索できるWebツール「ASMR声優横断検索」です。
画面自体は一般的な検索サイトに近いのですが、開発で時間をかけたのは、むしろその検索を成立させるデータ基盤でした。今回は、完成したツールの紹介に加え、異なるデータソースの統合、出演関係のモデル化、データの信頼性、差分更新と障害復旧を中心に、実際の設計を振り返ります。
目次
作成した「ASMR声優横断検索」
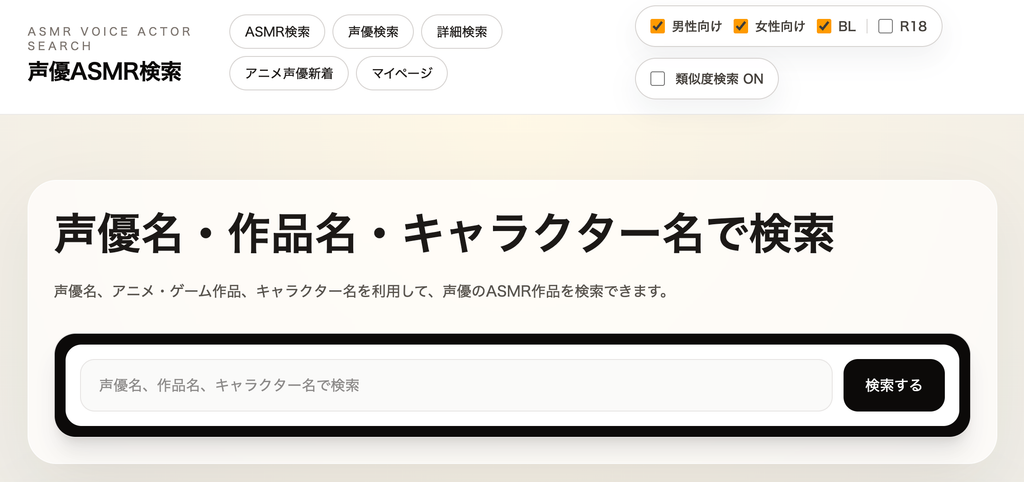
検索対象は声優だけではありません。アニメ・ゲームの作品、キャラクター、ASMR作品をそれぞれ検索でき、検索結果から関連する情報へ移動できます。
例えば、声優の詳細ページでは、出演するASMR作品とアニメ・ゲームの出演情報をまとめて確認できます。複数の声優を指定したAND・OR検索、お気に入り登録にも対応しています。
別名義での出演作品である可能性を関連候補として表示する類似度検索もありますが、その結果は本人・所属事務所が確認した情報ではなく、同一人物を保証するものでもありません。 あくまで作品を探すための参考情報です。
声優名から探す
例として、『ぼっち・ざ・ろっく!』の喜多郁代役や『葬送のフリーレン』のユーベル役などで知られる長谷川育美さんを検索してみます。
検索結果には声優の候補に加えて、関連するASMR作品やアニメ・ゲームの出演情報、キャラクターなどが表示されます。声優名を選ぶと、出演情報をまとめた詳細ページへ進めます。
キャラクター名から探す
声優名が分からない場合は、キャラクター名から検索できます。検索結果に担当声優が表示されるため、そこを起点にASMR作品へたどれます。
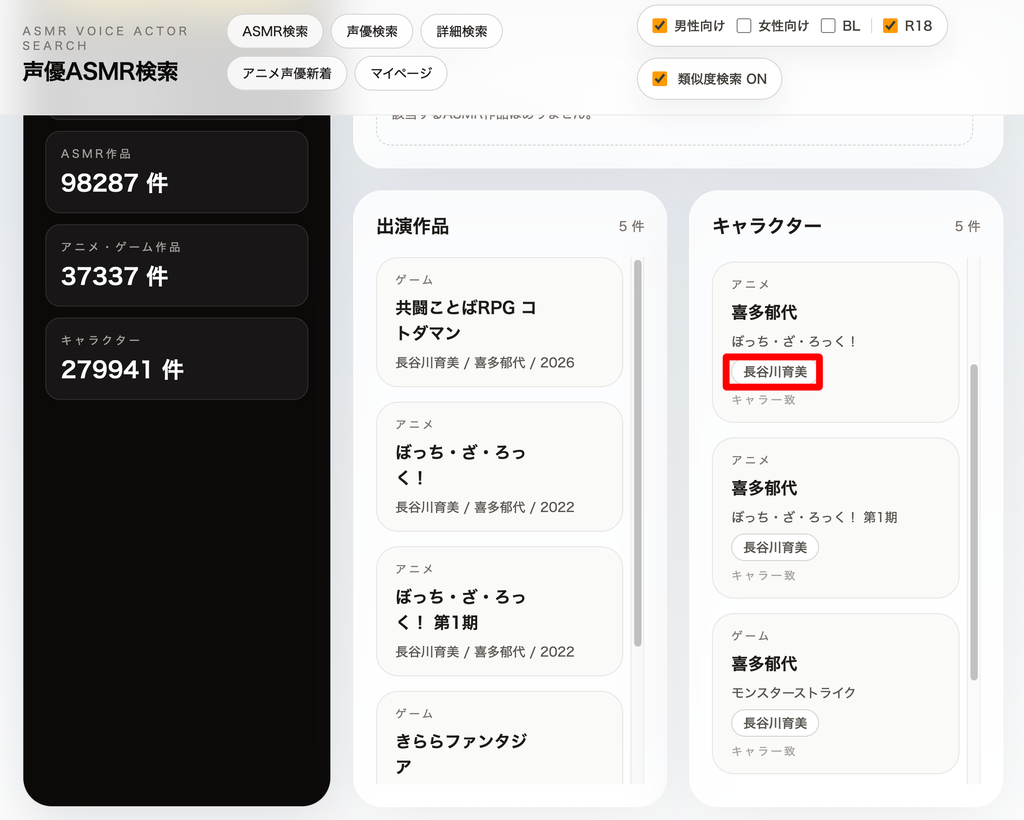
この使い方を実現するには、単に声優名とASMR作品名を対応させるだけでは不十分です。「作品―キャラクター―声優―ASMR作品」の関係をデータとして保持する必要があります。
操作手順を詳しく知りたい方は、画像付きの使い方解説記事にまとめています。ここからは、この横断検索をどう実現したのかを説明します。
課題1:情報源が分かれているデータを集める
アニメ・ゲームの出演情報とASMR作品の情報は、そもそも別々の場所にあります。しかも、同じ「出演情報」であっても、声優名だけが記載されているもの、担当キャラクターまで分かるもの、作品名の表記が異なるものなど、情報の粒度がそろっていません。
そこで、収集処理は情報源ごとに分け、検索時に利用するデータモデルは共通化する方針にしました。
Wikidataを主軸に、配役情報の不足を補う
声優・アニメ・ゲームの出演情報はWikidataを主な情報源にしています。Wikidataでは項目が固有IDで管理され、SPARQLで出演作品などの関係を取得できるため、文字列だけを集める場合よりも、後から情報を突き合わせやすい利点があります。
ただし、Wikidataの登録状況は作品によって大きく異なります。実装では、配役を伴う出演情報の取得に加えて、配役が取得できない場合にも出演者情報を補助的に使えるようにしています。例えば、配役に関係するP725が不足していても、出演者を示すP161の情報を手掛かりにできる場合があります。
ここで重要なのは、「その作品に出演した」と「どのキャラクターを演じた」は異なる事実という点です。声優と作品の関係だけが確認できる場合、キャラクター名を推測で埋めず、出演クレジットのcharacterIdを未設定(null)として保持できるようにしました。
こうしておけば、声優の出演作品一覧には反映しつつ、キャラクター名での検索に不正確な情報を混ぜることを避けられます。単に「データが取れた/取れなかった」の二択にせず、取得できた部分だけを保存する方針です。
ゲームのCSVを取り込む際の正規化
Wikidataだけで不足するゲームの出演情報には、「ゲーム名・キャラクター名・声優名」を持つCSVデータを併用しています。
ここで発生したのが、一つの声優名欄に複数名が記載されているケースです。例えば、説明用の仮例として「声優A/声優B」という値をそのまま人物マスタに登録すると、「声優A/声優B」という架空の一人ができてしまいます。
そのため、複数の出演者が含まれる入力は分離し、声優ごとに独立した出演クレジットとして扱う処理を設けました。既に取り込まれてしまった複合表記を分割できる処理も用意しています。
この例は小さな問題に見えますが、誤った人物レコードが一度作られると、そのレコードを起点とする検索結果にも影響します。収集時点の正規化は、後段の検索品質を守るための処理でもあります。
課題2:異なる情報源の「同じ人・同じ作品」をどう識別するか
データソースを増やすと、今度は同じ対象の情報が何度も入ってくるようになります。一方、名前の一致だけを頼りに統合すると、同姓同名や作品名の重複により、別の対象を誤って結び付ける危険があります。
外部IDを内部IDに直接置き換えない
DBには、VoiceActor(声優)、MediaWork(アニメ・ゲーム)、Character(キャラクター)、Work(ASMR作品)といったモデルがあります。これらに内部IDを割り当てたうえで、ExternalIdentityに情報源・外部キー・内部の参照先を保持します。
Wikidata側の識別子とDLsite側の識別子は同じ形式ではありません。内部IDと外部IDの対応を分けておけば、再収集時に既存レコードへ紐付けやすくなり、別のデータソースを追加するときも内部の関係を維持できます。
ただし外部IDがないCSVのような入力もあるため、名前・作品との対応などを利用した既存データ照合が別途必要です。外部IDは確実な照合材料の一つですが、万能な統合キーではありません。
出演クレジットを独立したモデルにする理由
声優と作品の関係は多対多です。ある声優が複数作品に出演する一方、一つの作品に複数の声優が出演することもあります。さらにアニメ・ゲームでは、そこにキャラクターという要素が加わります。
アニメ・ゲームの出演関係はVoiceActorCreditに、ASMR作品と声優の関係はWorkVoiceActorに保持しています。前者では声優・作品・キャラクターを参照し、後者では作品と声優の組を管理します。
source / reviewStatus / isManualOverride
出演情報を独立させることで、例えば「キャラクター名 → 出演クレジット → 声優 → ASMR作品」という経路をたどれます。また、出演クレジットには出典やレビュー状態などを持たせられるため、単なる文字列の対応表では扱いにくい情報も管理できます。
名称の表記揺れと、根拠のある統合を分ける
実際の情報には、キャラクター名がフルネームの場合と名前のみの場合、作品の正式名称と略称など、表記揺れがあります。検索側ではひらがな・カタカナの違いなど一部を吸収し、取り込み側でも既存レコードとの照合を行います。
ただし、検索で見つけやすくすることと、DBのレコードを同一だと確定することは同じではありません。 名前が似ているだけで別人物・別作品を一つにまとめないようにする必要があります。
このため、DBにはreviewStatusやconfidenceに加えて、出演情報の根拠を保持するCreditEvidence、照合候補を管理するReconciliationCandidateなどのモデルも用意しています。出典の異なる情報が衝突した場合に、確認対象として扱える構造です。
ここでの狙いは、すべての入力を自動的に「正しいデータ」にすることではありません。確定できないものを確定扱いせず、どの情報から得たのかを追える状態にしておくことです。
課題3:データを更新しながら、人手の修正を消さない
自動収集によってデータを増やしても、外部データ自体に誤りがあれば修正が必要です。そこで、声優や作品、出演情報を管理画面から手動編集できるようにしています。
ただし、ここで単純に外部データを再同期すると、管理者が直した情報が次の収集で元に戻る問題が起きます。削除した誤データが再作成される場合も同様です。
対策として、手動編集の保護にはisManualOverride、削除状態にはisDeletedなどのフラグを使っています。自動同期ではこれらを尊重し、手動で修正・削除した情報が無条件に上書き・復活しないようにしています。
たとえば、ある声優の出演クレジットを誤登録と判断して削除した場合、次回も同じ外部情報が取得されるかもしれません。削除フラグを尊重すれば、収集のたびに誤登録が復活することを防げます。
データソースを信頼して自動処理する部分と、人間の確認結果を優先する部分を明確に分けることが、継続運用では特に重要だと感じました。
課題4:全件再取得に頼らず、失敗しても再実行できる収集処理
データ収集は一度動けば終わりではありません。新作が増え、既存情報も更新され、外部サイトへのアクセスやDBへの書き込みに失敗する場合もあります。
そのため、収集の仕組みを初回収集、新着差分、既存作品の再取得に分け、処理の再実行も考慮しています。
DLsiteの初回収集と日々の差分収集
初回は声優ごとに登録された名義を利用して既存の作品を収集します。一方、継続運用では音声作品カテゴリの新着差分を取得するジョブを主系統として使い、声優単位の取得は補助・個別再取得に利用しています。
重要なのは、取得した差分をいきなりDBへ反映しない点です。まず差分をJSONとして保存し、そのJSONを入力にしてDBへ反映するようにしています。
これにより、外部からの取得に成功した後、DBの取り込みだけ失敗した場合でも、同じJSONから反映処理を再実行できます。問題の切り分けにも役立ちます。
発売からの経過に応じた再取得間隔
新作だけでなく、既存作品のメタデータも更新する必要があります。ただし、発売直後の作品と数年前の作品を同じ頻度で取得し直すのは効率的ではありません。
そこで、発売日の新しい作品ほど短い間隔で、古い作品ほど長い間隔で再取得する設計を採用しました。更新間隔を段階的に変え、古い作品の取得が一日に集中しないようにすることで、変化しやすいデータを優先しつつ処理負荷を分散できます。
これにより、単純な全件更新よりも外部アクセス量を抑えることを狙っています。ただし、どれだけ時間や通信量が減ったかについては、現時点で掲載できる実測値がないため、数値的な改善率は示しません。
部分失敗を失敗として見えるようにする
外部データの取得では、一部の対象だけが失敗することがあります。そのたびに全体を失敗として扱うと、取得できた情報まで無駄になります。
ジョブにはqueued、running、success、partial_success、failedなどの状態を持たせ、実行結果とエラーを記録できるようにしています。失敗情報はIngestionErrorに保存する設計です。
また、収集処理によっては途中再開や対象ごとの再試行に対応し、処理済みの部分をなるべく繰り返さずに済むようにしています。「成功したデータを保持すること」と「失敗した対象を追跡できること」は、長く運用する際にどちらも必要です。
技術構成:検索と収集の責務を分ける
使用している主な技術は次のとおりです。
| 技術 | 担当する役割 |
|---|---|
| Next.js / React / TypeScript | 検索画面、各種API、管理画面 |
| PostgreSQL / Prisma | 作品・声優・出演クレジット・収集状態などの管理 |
| Python Worker | DLsiteの作品情報取得 |
| Wikidata SPARQL | 声優・アニメ・ゲームの構造化データ取得 |
| Docker Compose | Webアプリ、DB、Worker、スケジューラの構成管理 |
Next.jsで検索画面とAPIを提供しつつ、データ取得のジョブは別の役割として実行しています。Webアクセスに応答する処理と、外部から大量の情報を収集する処理を分離できるため、機能ごとの変更や運用時の確認を行いやすい構成です。
また、本番ではスケジューラから定期ジョブを起動し、新着作品や出演情報を更新しています。管理画面から個別の再取得を実行できるようにしているのも、すべてを自動同期だけで解決しようとしないためです。
開発して分かったことと、残っている課題
今回、最も重要だと感じたのは、検索の精度や使い勝手は、検索画面だけでは決まらないということです。出演情報が不足していれば、どれだけ使いやすいUIを用意しても作品は見つかりません。逆に、誤った出演関係を登録すれば、検索結果の信頼性が下がってしまいます。
Wikidataだけでは足りなかったため、Wikipedia・Pixiv百科事典やゲームCSVの補完を追加しました。しかし、情報源が増えるほど、同一対象の識別、表記揺れ、出典の管理、レビューの必要性も増します。そこで、出典や確認状態を保持するDB設計と、手動修正を尊重する同期処理が必要になりました。
さらに、公開後はデータを更新し続けなければなりません。差分JSONの保存、失敗したジョブの追跡、再取得間隔の調整は、検索サイトを継続して使える状態にするための工夫です。
今後の課題は、アニメ・ゲームの出演情報の網羅性と、異なる情報源のデータ照合の精度です。情報を増やすだけでなく、誤った関連付けを増やさないよう、収集と確認の両面を改善していきたいと考えています。
まとめ
「ASMR声優横断検索」は、キャラクター名から担当声優を調べ、その声優のASMR作品まで探せるWebツールです。
開発の中心になったのは、単なる検索APIではなく、外部データの不足を補う収集処理、内部IDを中心とした出演関係の管理、不確かな情報の扱い、手動修正を守る同期、失敗から復旧できる更新基盤でした。
同じように複数のデータソースを横断するWebサービスを作る際には、最初から「収集後の照合」と「更新時の振る舞い」を考えておくことが、後々の運用を大きく左右すると感じています。
ツールはWeb上で公開しています。気になる声優さんやキャラクターがあれば、ぜひ試してみてください。
声優名からASMRを探してみる
以下の検索ボックスから直接検索できます。
画面の使い方や検索結果の見方は、「ASMR声優横断検索」の画像付き解説記事で詳しく紹介しています。